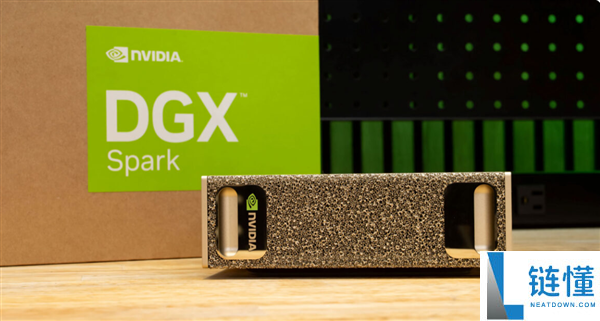
9月5日消息,英伟达开发者论坛用户ciprianveg近日公布了一项本地AI算力测试,通过将16台英伟达DGX Spark组成运算集群,成功运行了完整的Kimi-K3大模型。测试结果表明,该系统在16000深度下的最高生成速度可达38 t/s。
英伟达DGX Spark原本是面向本地AI开发和推理的桌面设备,随着Qwen、DeepSeek等模型的普及,单台设备的计算和显存资源往往难以满足千亿参数模型的需求。
该项目通过直接增加计算节点的方式,将应用场景从单机测试扩展到了多机并行。

为了满足16台设备协同工作时庞大的数据吞吐需求,该项目在网络互联上进行了专门配置,系统通过一台MikroTik CRS804-4DDQ核心交换机进行网络调度,并搭配4根400G转4×100G的高速分支线缆,将所有GB10节点串联。
系统运行基于Inferact/Kimi-K3-DSpark环境,以分布式方式首次启动了该模型。
具体的基准测试成绩上,集群在4000深度下,预填充(即模型处理输入提示词的准备阶段)吞吐量为654.89 t/s,首次响应时间约8.3秒,生成速度为21.71 t/s。
当上下文深度增加至16000时,预填充吞吐量提升至758.78 t/s,首次响应等待时间延长至约21.5秒,但生成速度反而提升至25.39 t/s,峰值达到38.00 t/s。
该发帖人还表示,这仅是未经过充分调优的首次测试成绩,后续他计划继续优化整体性能,并将在近期把运行镜像和使用说明上传至代码托管平台GitHub。

 浏览量
 浏览量
 浏览量
 浏览量
 浏览量
 浏览量
 浏览量
 浏览量
 浏览量
 浏览量